База знаний для AI-поддержки: почему 982 статьи работали хуже, чем 38

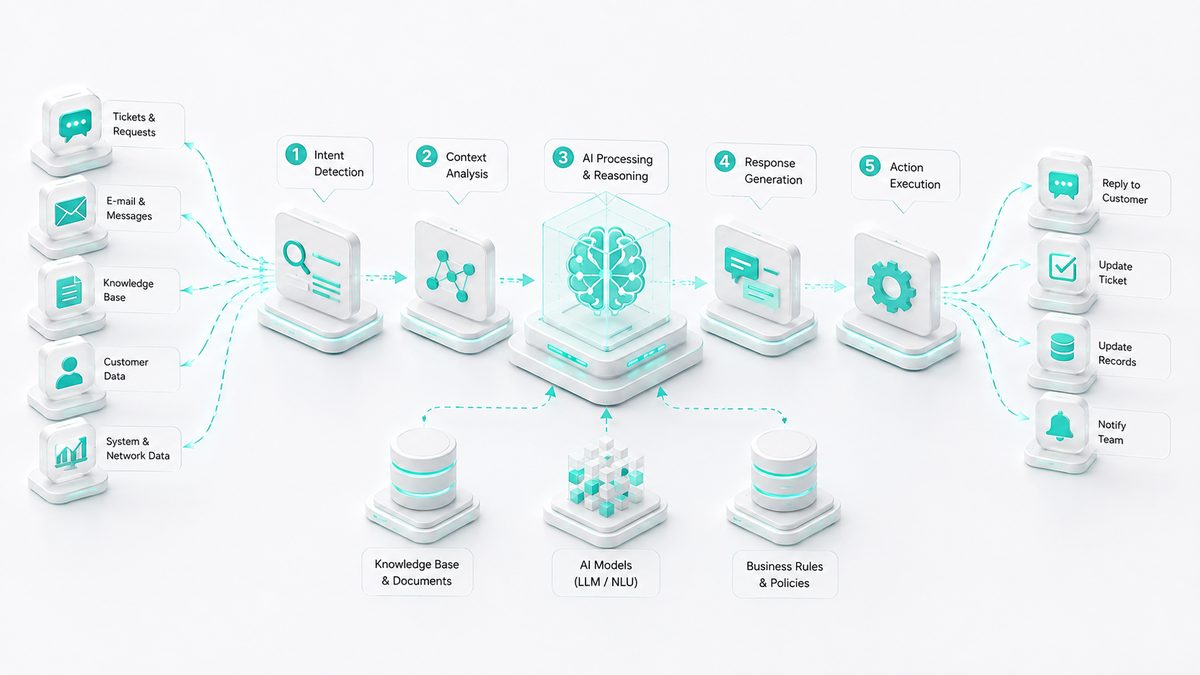
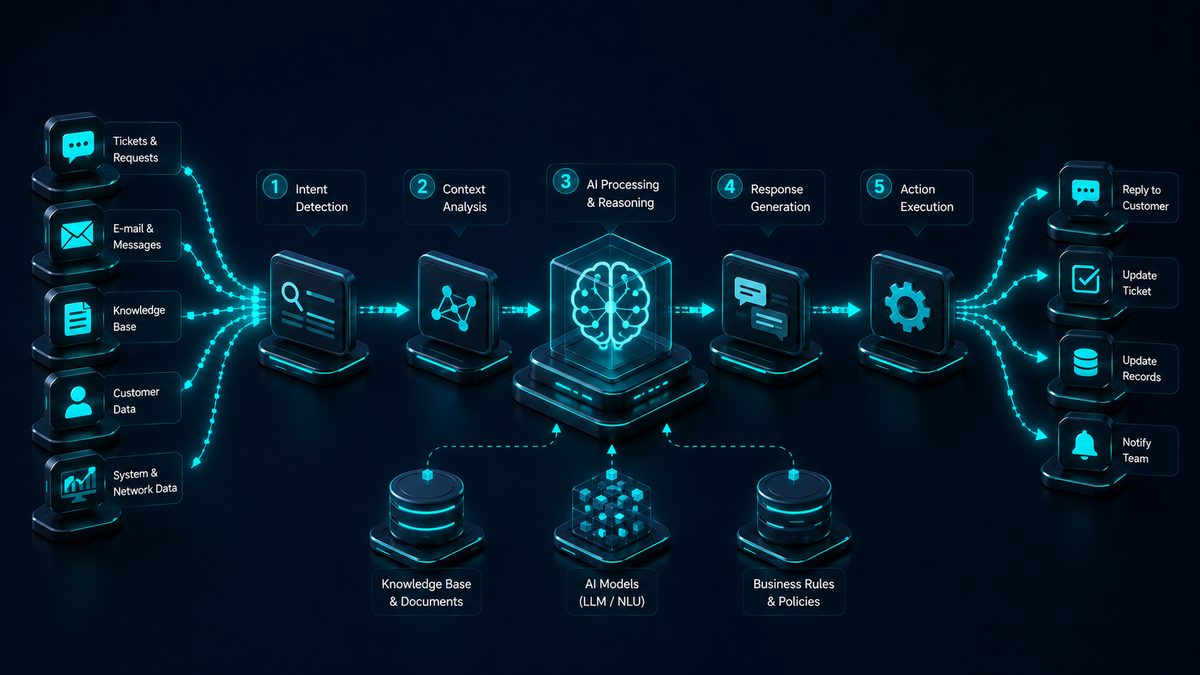
У AI-поддержки есть невидимая часть, которая решает почти всё: база знаний. Модель сама по себе не знает, что «сессия в килобайтах» — признак физической проблемы на линии, а логин в личный кабинет всегда равен номеру договора. Это знание живёт в статьях, и в промпт каждого ответа попадает не вся база, а несколько статей, отобранных под конкретный вопрос.
Поэтому вопрос «сколько у вас статей» бессмысленный. Правильный вопрос — какие восемь статей увидит модель, когда клиент напишет «пропал инет».
Мы разобрали свою базу и нашли там три проблемы, каждая из которых тихо портила ответы. Ни одна не видна, пока смотришь на общий счётчик.
Проблема первая: счётчик показывает 982, а работают 58
В базе лежало 982 статьи. Из них 916 — выгрузка технической документации с пометкой «для операторов»: в подсказки боту она не идёт и идти не должна. Клиентских сценариев оставалось 58.
Это нормально. Ненормально другое: 26 из этих 58 оказались обрывками одной таблицы. Когда-то чек-лист «нет интернета» импортировали построчно, и каждая строка стала отдельной «статьёй» по 83 символа: «5: Баланс положительный?», «6: Горит ли LOS на ONU?».
Формально база выросла. Фактически — отбор статей под вопрос стал вытаскивать эти огрызки вместо целых сценариев: половина мест в подсказке уходила на строчки, из которых ничего не следует.

Собрали обрывки обратно в четыре чек-листа — «нет интернета», «низкая скорость», «расторжение и удержание», «баланс и вход в кабинет». Ничего не выдумывали: тот же текст, только сведённый в связный порядок шагов со ссылками на профильные сценарии.

Счётчик после этого уменьшился — 38 статей вместо 58. Полезного текста стало больше: 22 тысячи символов против 19 тысяч.
Проблема вторая: ключевые слова написаны не тем языком
Отбор статьи под вопрос работает по ключевым словам, заголовку и описанию проблемы. Слова эти обычно пишет тот, кто составлял статью, — и пишет он их так, как принято у него в голове.
Мы выгрузили 4403 сообщения клиентов за год и посмотрели, какими словами люди на самом деле описывают неполадки. Оказалось: «пропал интернет», «отключился», «отсутствует», «интернета нет», «инет», «вай фай», «кабель цел», «перезагрузка не помогает», «услуги заблокированы (долг)». В ключевых словах статей половины этих формулировок не было.
Заодно нашлась вещь помельче, но обиднее: у восьми статей в поле ключевых слов лежала памятка оператору вместо слов — «Смена тарифа → проверить текущий, озвучить доступные. Проверить нет ли долга». Совпадения по такому полю случайны. Памятку перенесли в текст статьи, где она полезна модели, а ключевые слова заполнили нормально.
После правки проверили отбор на живых фразах:
| Клиент пишет | Какие статьи уходят в подсказку |
|---|---|
| пропал интернет | «Нет интернета», первичный ответ, чек-лист |
| услуги заблокированы долг | Чек-лист по балансу, «Вопросы оплаты» |
| кабель цел перезагрузка не помогает | Чек-лист «нет интернета», диагностика линии |
| у соседей тоже не работает | «Массовая авария» |
| телевизор вышел из группы | «IPTV / Телевидение» |
Проблема третья: выключенные статьи, о которых все забыли
Восемь статей висели выключенными — черновики, сделанные когда-то из разборов диалогов. Половина дублировала действующие сценарии, но две закрывали реальные дыры: что делать, когда не проходит ни звонок с кодом, ни SMS, и что отвечать, когда номер клиента вообще не найден в системе. Обе включили.
Дубли не удалили — перевели в аудиторию «оператор». Из подсказок боту они ушли, текст остался: удалять то, что писали руками, ради чистоты счётчика — плохая привычка.
Что из этого следует для провайдера
- Размер базы — не показатель. Смотреть надо на то, сколько статей реально видит бот и что попадает в подсказку по типовому вопросу.
- Ключевые слова пишут клиенты, а не вы. Выгрузите свои обращения за год и сверьтесь: скорее всего, вы называете проблему иначе, чем ваши абоненты.
- Импорт таблиц надо проверять глазами. Построчный импорт превращает чек-лист в мусор, который выглядит как рост базы.
- Выключенные статьи стоит пересматривать. Черновик, который никто не включил, — это либо дубль, либо забытая дыра в сценариях.
Как это работает в СмИТ Биллинге
База знаний — отдельный раздел платформы, а не файл в репозитории. У каждой статьи есть код, приоритет, аудитория (бот, оператор или оба) и привязка к организации: в мультибрендовой установке у каждого провайдера могут быть свои сценарии поверх общих.
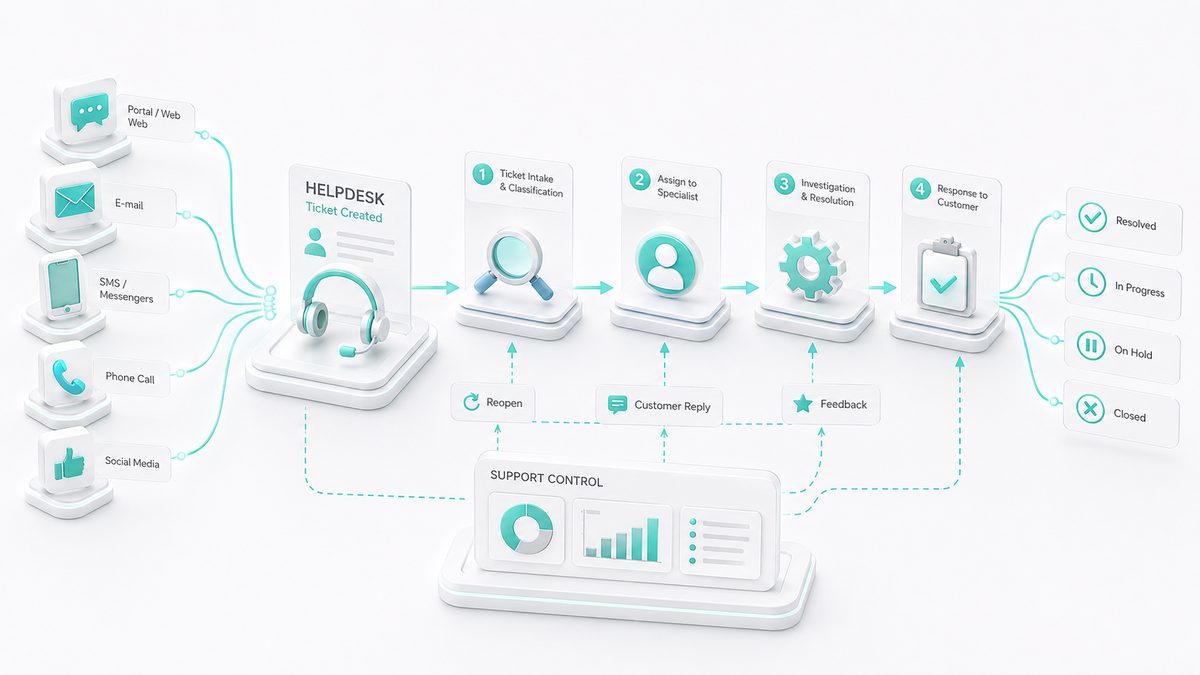
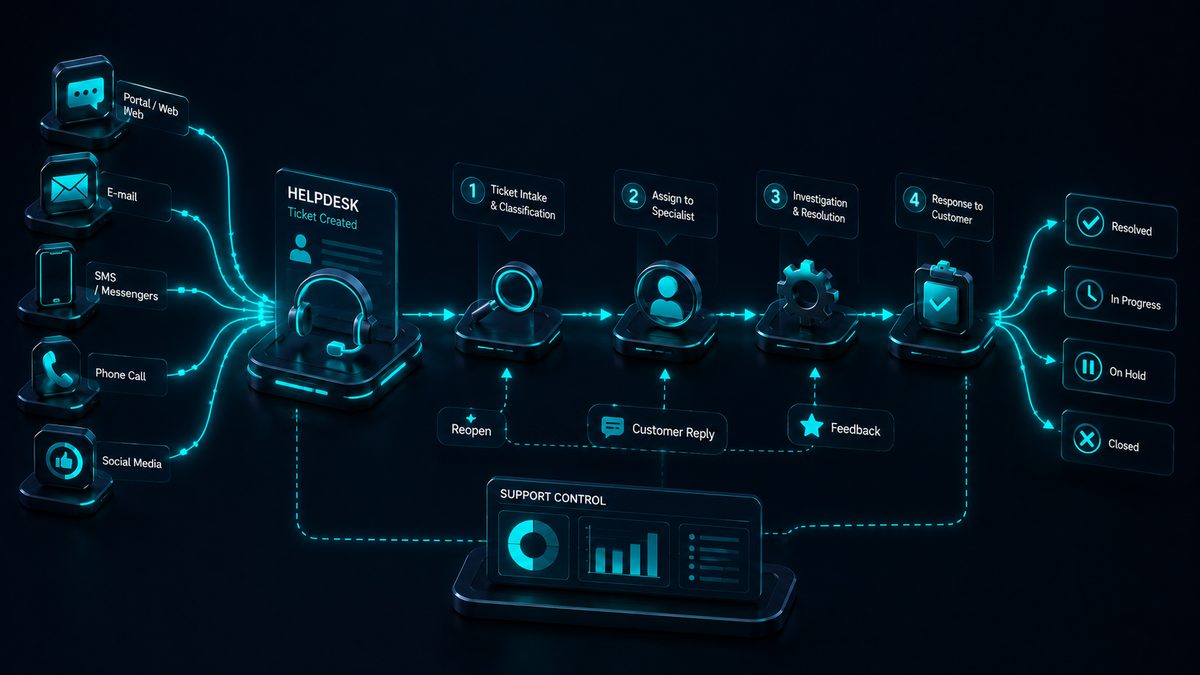
Рядом — аналитика обращений из модуля «Поддержка»: видно, какие категории приходят чаще всего и какой сценарий за них отвечает. Если у категории с долей 10% нет сценария, это и есть следующая статья, которую надо написать.

Проверять отбор можно не на ощупь: помощник в панели показывает, что именно уходит в подсказку по конкретной фразе. Это скучная работа на полчаса, которая делает ответы бота заметно точнее — без единой правки в модели и промпте.
Посмотреть на своих данных
Покажем платформу на живом стенде и разберём ваш случай. Или спросите ассистента прямо сейчас — он отвечает по документации и настройкам.
Читайте также

AI-агент в поддержке: что он закрывает сам, а что отдаёт человеку
Три четверти обращений закрываются без оператора — но только если агент подключён к биллингу и умеет вовремя позвать человека. Разбираем, где проходит эта граница.

Оборудование под подотчёт: как склад перестаёт быть тетрадкой
Роутеры «где-то у монтажников», недостача, которую находят раз в год, и списание задним числом. Как выглядит учёт, при котором вещь всегда числится за кем-то одним.

Платежи юрлиц: как перестать разбирать выписку руками
Оплата пришла, а клиент числится должником и уходит в блокировку. Разбираем путь платежа от письма банка до зачисления и то, почему часть платежей всегда придётся смотреть глазами.